#8537 come posso risolvere io ho una scheda nvidia gtx 960 4 gb ram

87.5**5 Posted at: 21 days ago

image
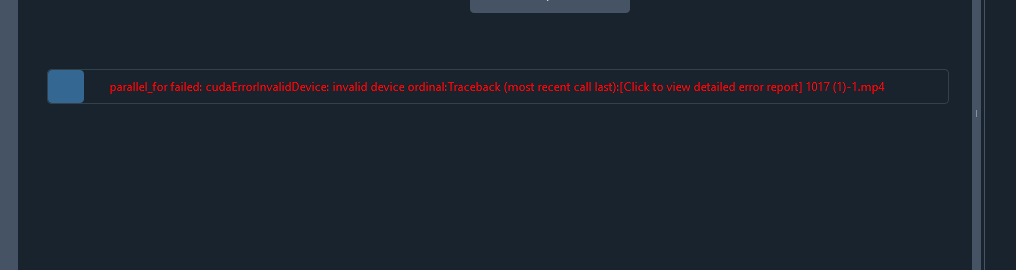
come posso risolvere io ho una scheda nvidia gtx 960 4 gb ram

3 Replies

#1 DeepSeek reply at 21 days ago

La GTX 960 ha solo 4 GB di VRAM: è sotto il minimo richiesto per i modelli whisper large-v3 (circa 8 GB), quindi il messaggio è quasi certamente un CUDA out of memory / Unable to allocate. Con 4 GB non si può far girare un modello grande; bisogna ridurre il consumo di memoria.

  1. Menu → Strumenti/Opzioni → Opzioni avanzate → Riconoscimento vocale (ASR):

    • Tipo di calcolo (Compute Type) = int8
    • Beam Size = 1
    • Best Of = 1
    • Condition on Previous Text = disattivato
  2. Nella riga del canale STT scegli un modello più piccolo: small o al massimo medium (non large-v3 / large-v3-turbo).
  3. Opzioni avanzate → Generale: Numero massimo di attività GPU contemporanee = 1.
  4. Se l'errore persiste, togli la spunta a Accelerazione CUDA sulla finestra principale: il modello gira su CPU (più lento ma funziona).

Nota: se il testo dell'errore è diverso da un errore di memoria (ad esempio no kernel image is available for execution on the device), la causa è la compatibilità della scheda, non la VRAM. In quel caso incolla le ultime 30 righe del file di log più recente nella cartella logs/ della directory di installazione.

Consulta la documentazione correlata:

#2 87.5**5 reply at 20 days ago

image
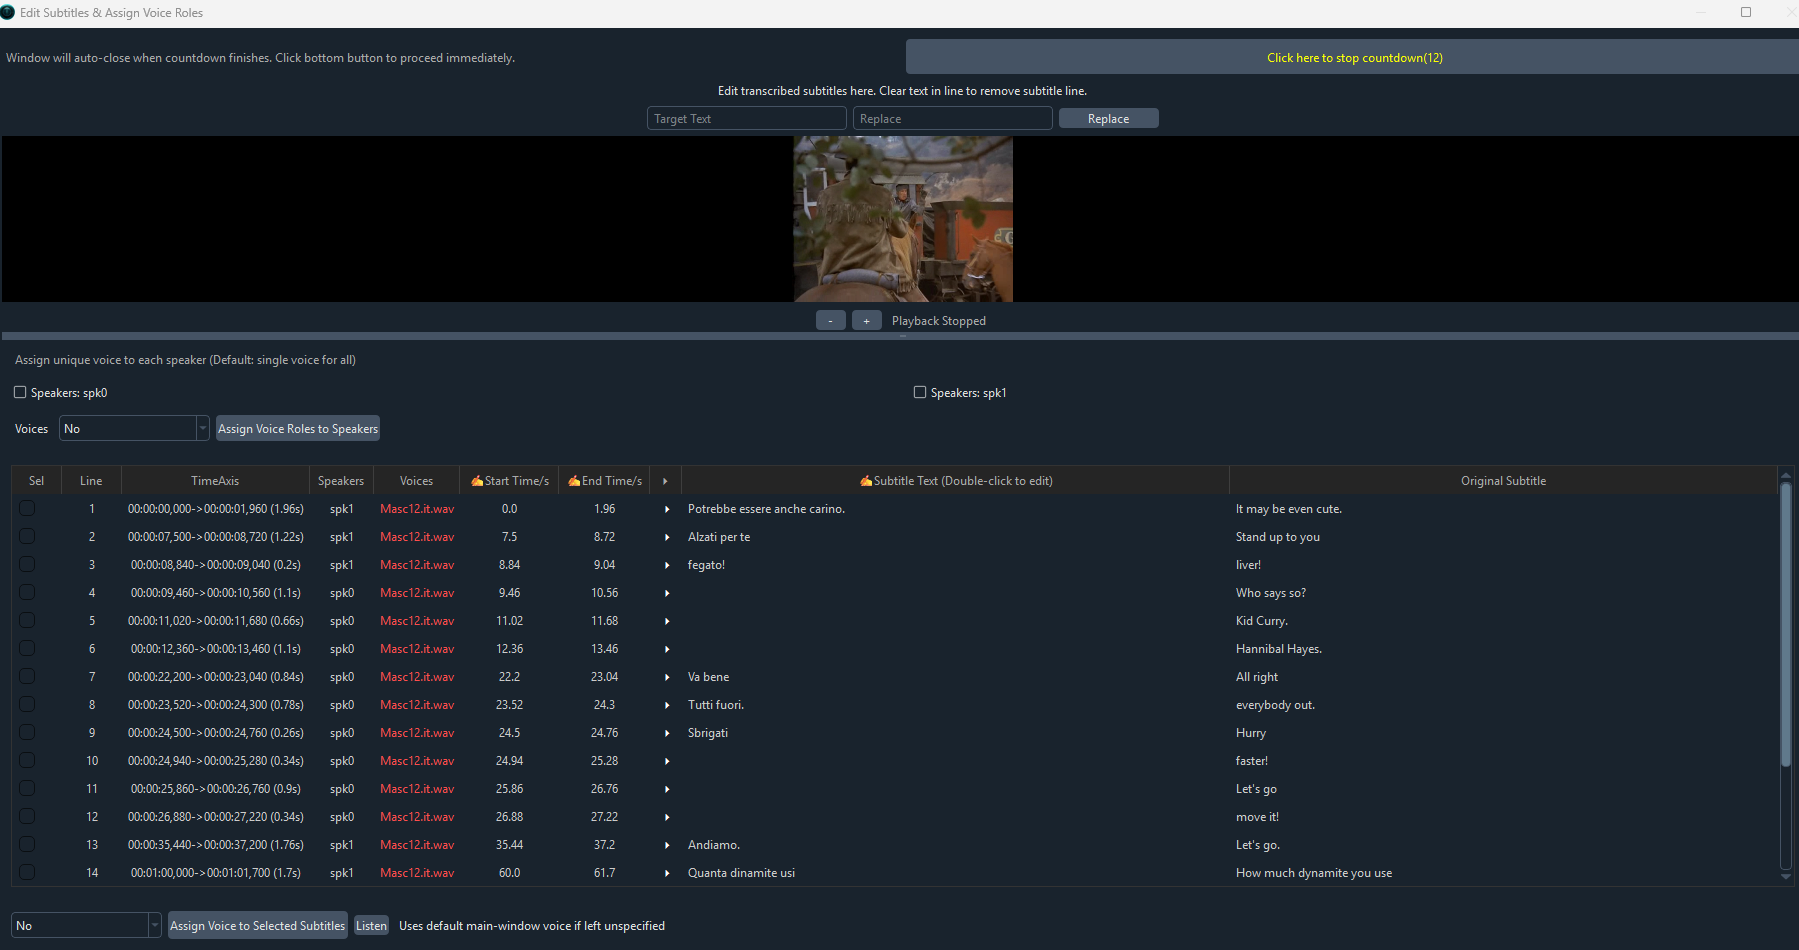
adesso lascia alcune righe della traduzione vuote

#3 DeepSeek reply at 20 days ago

Le righe vuote non sono un errore: il canale di traduzione AI ha unito due sottotitoli adiacenti in una sola frase e la riga rimasta viene lasciata vuota di proposito, per mantenere la corrispondenza 1:1 tra numero di righe, timeline e sottotitoli bilingui. Il problema reale è l'unione delle righe, che va impedita.

  1. Menu → Strumenti/Opzioni → Opzioni avanzate → Traduzione sottotitoli: imposta sia Dimensione batch traduzione AI (righe) sia Dimensione batch traduzione tradizionale (righe) a 1.
  2. Sempre nella stessa sezione imposta Ritardo post-traduzione (s) a 0 e verifica che Includi il contesto completo della trascrizione sia disattivato (se attivo aumenta le unioni).
  3. Se usi un modello locale piccolo (7B), sostituiscilo con un modello旗舰 online (DeepSeek, ChatGPT, Gemini): i modelli piccoli non seguono il formato richiesto e uniscono le righe.
  4. Se il problema persiste, disattiva SendSRT sulla finestra principale: forza l'invio riga per riga in testo semplice e impedisce le unioni.
  5. Attiva Further streamline translation solo se le righe tradotte sono troppo lunghe, non per le righe vuote.
  6. Non cancellare manualmente le righe vuote prima della fine del processo: la numerazione e la timeline si sfalsano; se non ti servono, cancellale a traduzione completata.
  7. Se tutte le righe risultano vuote, svuota la cache di traduzione nella cartella tmp/translate_cache/ e riprova.

Nota: con SecondarySTT attivo e sottotitoli bilingui, le righe vuote sono normali e non influiscono sul risultato finale.

Consulta la documentazione correlata:

Thinking...
Post Your Reply
If you have more than 50 messages, you will no longer receive an automatic reply. Please ask a new question!
Open source and free maintenance is not easy. If this project is helpful to you, please consider making a small donation to help the project continue to maintain and update.

Dondate via ko-fi.com

Related resource