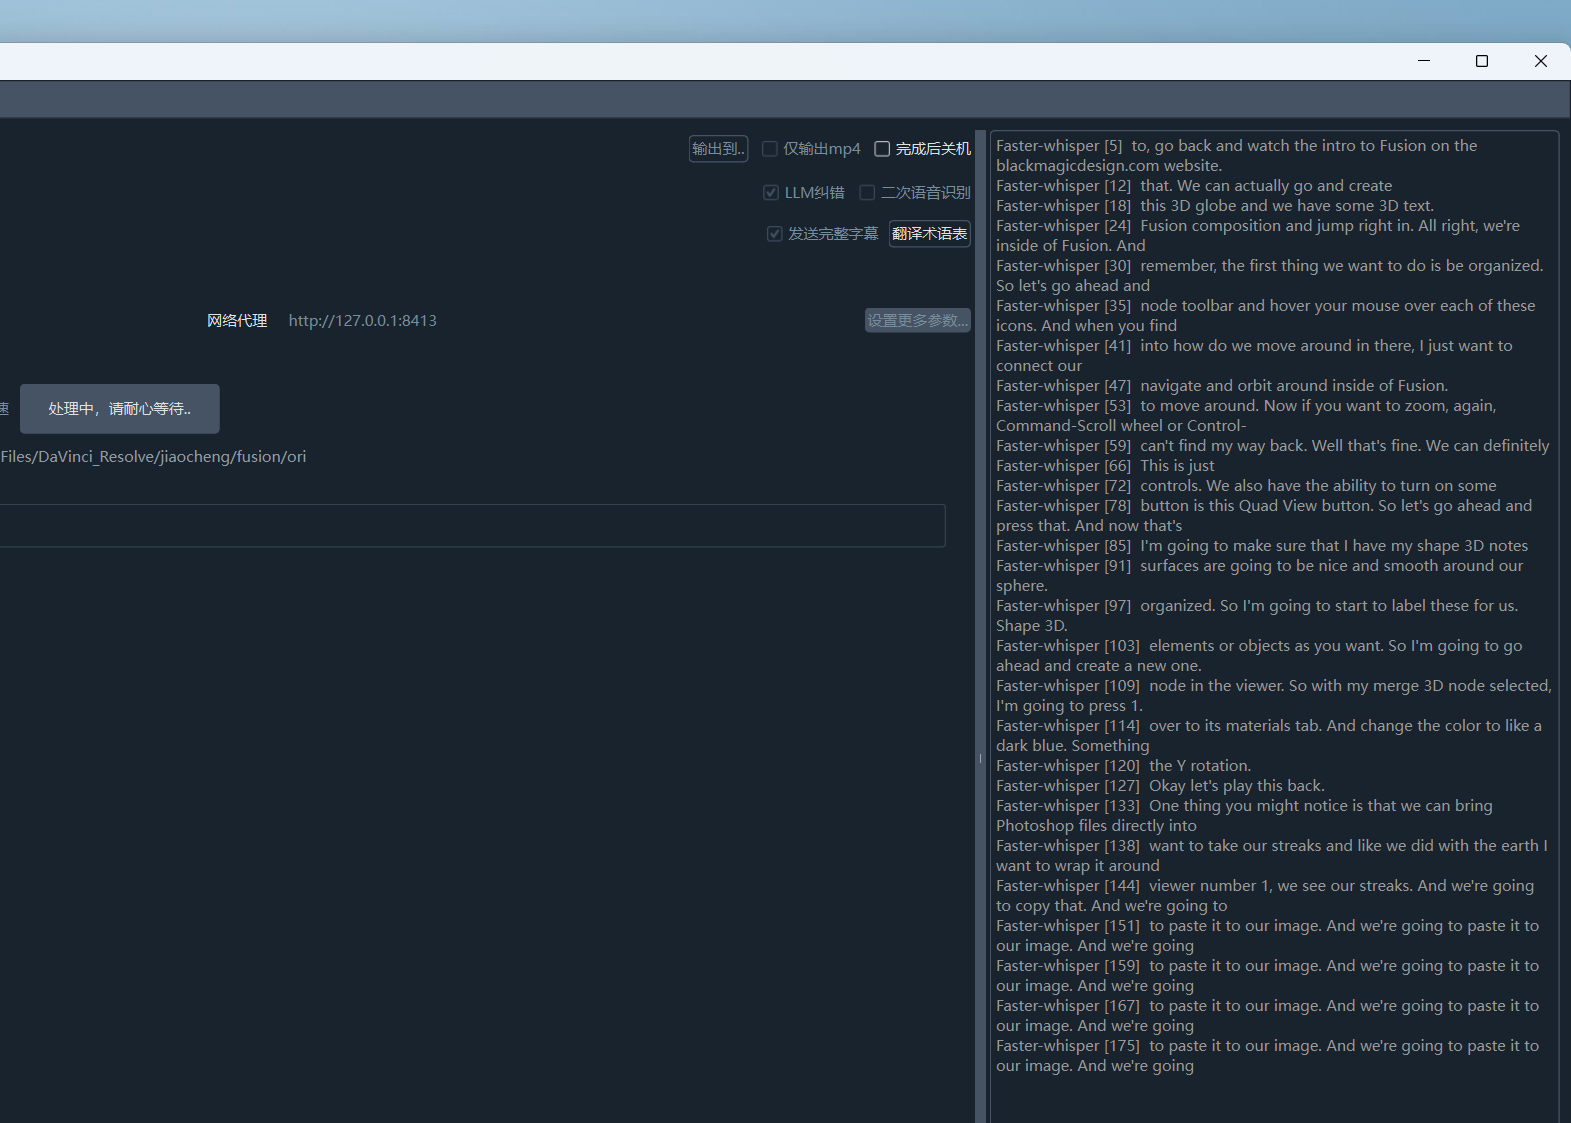
#8796 提取语音转文字的时候,一直重复,是什么原因?

2600**61e6 Posted at: 2 days ago

提取image
语音转文字的时候,一直重复,是什么原因?

1 Replies

#1 DeepSeek reply at 2 days ago

这是 Whisper 系列模型(faster-whisper / openai-whisper)典型的“幻觉重复”现象:在背景噪声大、静音段或音乐段较长、VAD 切分不合理,或解码参数过于宽松时,模型会把同一句话反复输出。

按以下顺序调整,通常可解决:

  1. 高级选项 → 语音识别参数,修改解码参数:

    • 重复惩罚:调大(如 1.2~1.5),有利于减少重复(默认值偏保守)
    • 文本压缩率:调小(如 1.0 或更低),减小有利于减少重复
    • 采样温度:调低或设为 0,降低随机发散导致的循环
    • 启用上下文感知:取消勾选(开启虽占用更多 GPU、效果更好,但极易出现重复或幻觉)
  2. 高级选项 → 语音识别参数 → VAD 相关:

    • 语音阈值:适当调高,避免把噪声、音乐误当人声送入识别
    • 非语音阈值:适当调大,可降低幻觉(但过大会漏字)
    • 最长语音持续 若设得过大,长片段的重复概率更高,可适当调小(如 5~8 秒)
  3. 在“设置更多参数”中勾选 降噪,或勾选 分离人声背景声:背景音乐/噪声是重复的主要诱因之一。
  4. 明确指定 发音语言,不要选 自动检测;并将识别模型换成 large-v3 或 large-v3-turbo(小模型重复率明显更高)。
  5. 使用 热词(高级选项 → 语音识别参数) 填入视频中反复出现的关键词,可抑制无意义重复。
  6. 重试前务必勾选主界面的 清理已生成,否则会复用上次已生成的错误字幕文件。

若以上都无效,可尝试切换识别渠道(如 Qwen-ASR(内置)、阿里FunASR(内置)、Firered中文(内置))对照测试,以判断是否为该模型对当前音频的固有问题。

请查阅相关文档:

Thinking...
Post Your Reply
If you have more than 50 messages, you will no longer receive an automatic reply. Please ask a new question!
Open source and free maintenance is not easy. If this project is helpful to you, please consider making a small donation to help the project continue to maintain and update.

Dondate via ko-fi.com

Related resource