#7677 语音识别阶段出错[Huggingface_ASR(内置)] The expanded size of the tensor (13350) must match the existing size (3000) at non-singlet

182.147**1 Posted at: 1 hour ago

语音识别阶段出错[Huggingface_ASR(内置)] The expanded size of the tensor (13350) must match the existing size (3000) at non-singleton dimension 1. Target sizes: [128, 13350]. Tensor sizes: [128, 3000]:Traceback (most recent call last):
File "videotrans\process\stt_pipe.py", line 61, in pipe_asr
File "D:\PY\_internal\transformers\pipelines\automatic_speech_recognition.py", line 247, in call

return super().__call__(inputs, **kwargs)

File "D:\PY\_internal\transformers\pipelines\base.py", line 1257, in call

outputs = list(final_iterator)

File "D:\PY\_internal\transformers\pipelines\pt_utils.py", line 126, in next

item = next(self.iterator)

File "D:\PY\_internal\transformers\pipelines\pt_utils.py", line 271, in next

processed = self.infer(next(self.iterator), **self.params)

File "D:\PY\_internal\torch\utils\data\dataloader.py", line 733, in next

data = self._next_data()

File "D:\PY\_internal\torch\utils\data\dataloader.py", line 789,
......
ch the existing size (3000) at non-singleton dimension 1. Target sizes: [128, 13350]. Tensor sizes: [128, 3000]:Traceback (most recent call last):
File "videotrans\process\stt_pipe.py", line 61, in pipe_asr
File "D:\PY\_internal\transformers\pipelines\automatic_speech_recognition.py", line 247, in call

return super().__call__(inputs, **kwargs)

File "D:\PY\_internal\transformers\pipelines\base.py", line 1257, in call

outputs = list(final_iterator)

File "D:\PY\_internal\transformers\pipelines\pt_utils.py", line 126, in next

item = next(self.iterator)

File "D:\PY\_internal\transformers\pipelines\pt_utils.py", line 271, in next

processed = self.infer(next(self.iterator), **self.params)

File "D:\PY\_internal\torch\utils\data\dataloader.py", line 733, in next

data = self._next_data()

File "D:\PY\_internal\torch\utils\data\dataloader.py", line 789, in _next_data

data = self._dataset_fetcher.fetch(index)  # may raise StopIteration

File "D:\PY\_internal\torch\utils\data\_utils\fetch.py", line 43, in fetch

return self.collate_fn(data)

File "D:\PY\_internal\transformers\pipelines\base.py", line 174, in inner

padded[key] = _pad(items, key, _padding_value, padding_side)

File "D:\PY\_internal\transformers\pipelines\base.py", line 110, in _pad

tensor[i, : len(item[key][0])] = item[key][0]

RuntimeError: The expanded size of the tensor (13350) must match the existing size (3000) at non-singleton dimension 1. Target sizes: [128, 13350]. Tensor sizes: [128, 3000]
[SpeechToText]语音转录: self.out_format='srt',self.copysrt_rawvideo=False,self.spk_insert=True
[TaskCfgSTT]
原始输入文件名: D:/无码/004433.xyz 1pondo-120822_001.mp4,
输出结果保存到文件夹: D:/PY/output/recogn,
临时文件夹: D:/PY/tmp/3576/93130ed901
已启用CUDA加速
未选 降噪
语音识别:Huggingface_ASR(内置), kotoba-tech/kotoba-whisper-v2.0 断句方式:默认断句
发音语言:ja
未选 降噪


=
system:Windows-10-10.0.19045-SP0
version:v4.14
frozen:True
language:zh_CN
root_dir:D:/PY
49 Replies

#1 DeepSeek reply at 1 hour ago

这是 Huggingface_ASR(内置) 渠道使用 kotoba-tech/kotoba-whisper-v2.0 模型时的批处理张量拼接错误(批次内音频切片长度不一致导致对齐失败)。请按以下顺序处理:

  1. 改用更稳定的日语识别渠道(推荐,最省事)
    主界面语音识别渠道改为 faster-whisper(内置) 或 openai-whisper(内置),模型选 large-v3。这两个渠道对日语支持良好,且不会出现此批处理拼接错误。
    若一定要用 HuggingFace 系模型,可改用 Huggingface_ASR(内置) 里的 reazon-research/japanese-wav2vec2-large-rs35kh,或直接用 Nemotron-3.5-asr-0.6b(内置)(支持日语)。
  2. 调小 VAD 最长语音持续时长(若仍需用该渠道)
    进入 菜单 -> 工具/选项 -> 高级选项 -> 语音识别参数,把 最长语音持续(秒) 从默认值调小(如 3~4),让单条切片更短、批内长度差异更小,可规避该张量对齐报错。
  3. 可选:勾选降噪/人声分离
    点击主界面 设置更多参数,选中 降噪 或 分离人声背景声,减少背景噪声造成的切片长度剧烈波动。
  4. 重启软件后再试(该渠道在子进程中运行,出错后进程池需重建)。

如按上述仍报同样错误,请提供软件安装目录下 logs/ 文件夹中最新的日志文件(复制底部约30行)。

请查阅相关文档:

#2 182.147**1 reply at 1 hour ago

提取日语视频,用什么模型效果最好V2.V3.V3T都漏字

#3 DeepSeek reply at 1 hour ago

日语视频漏字(识别不全)通常是模型选型 + VAD 切分参数共同导致的。

建议按以下方向调整:

一、优先换用日语专用识别渠道

Whisper 通用模型(v2/v3/v3-turbo)对日语的漏字问题较常见,改用日语专用模型效果更好:

渠道模型说明
Huggingface_ASR(内置)reazon-research/japanese-wav2vec2-large-rs35kh日语专用,推荐
Huggingface_ASR(内置)kotoba-tech/kotoba-whisper-v2.0日语专用(你上次报错的那个,需先解决张量对齐问题)
Nemotron-3.5-asr-0.6b(内置)Nemotron-3.5-asr-streaming-0.6b英伟达开源多语言,支持日语
openai-whisper(内置)large-v3通用模型里日语表现较好

二、调整 VAD 切分参数(解决漏字核心)

进入 菜单 → 工具/选项 → 高级选项 → 语音识别参数:

  • 最长语音持续(秒):调至 8 或 10(避免语句被生硬切断造成漏字)
  • 最短语音持续(毫秒):调至 1000~1500(防止短促音节被吞掉)
  • 静音分割持续(ms):调至 800(日语停顿较短,避免过度切分)
  • 语音阈值(VAD Speech probability threshold):适当调小(更灵敏,减少整句被当噪声过滤)
  • 非语音阈值(no speech threshold):适当调小(降低漏字率)

三、提升识别精度参数

  • 识别准确度 beam_size:调到 5(默认值越高越准)
  • 识别准确度 best_of:调到 5
  • 启用上下文感知:勾选(体验更好,但更耗显存)

四、预处理建议

主界面点击 设置更多参数,勾选 降噪,或勾选 分离人声背景声(有背景音乐/噪声时强烈建议),能显著提升识别准确率、减少漏字。

五、务必启用 GPU 加速

日语模型较大,CPU 运行不仅慢,部分场景精度也会受影响。

确保已选中 启用CUDA加速(需 N 卡 + CUDA 12.8 + cuDNN 9)。


推荐组合(日语最优):Huggingface_ASR(内置) + reazon-research/japanese-wav2vec2-large-rs35kh,配合 降噪 + 最长语音持续10秒 + beam_size=5。

请查阅相关文档:

#4 182.147**1 reply at 1 hour ago

kotoba-tech/kotoba-whisper-v2.0 日语专用(你上次报错的那个,需先解决张量对齐问题) 怎么设置这个问题

#5 DeepSeek reply at 1 hour ago

kotoba-whisper-v2.0 的 [128, 13350] vs [128, 3000] 报错,本质是 transformers 管道在批处理时,把长度不同的音频切片强行 padding 对齐失败导致的。

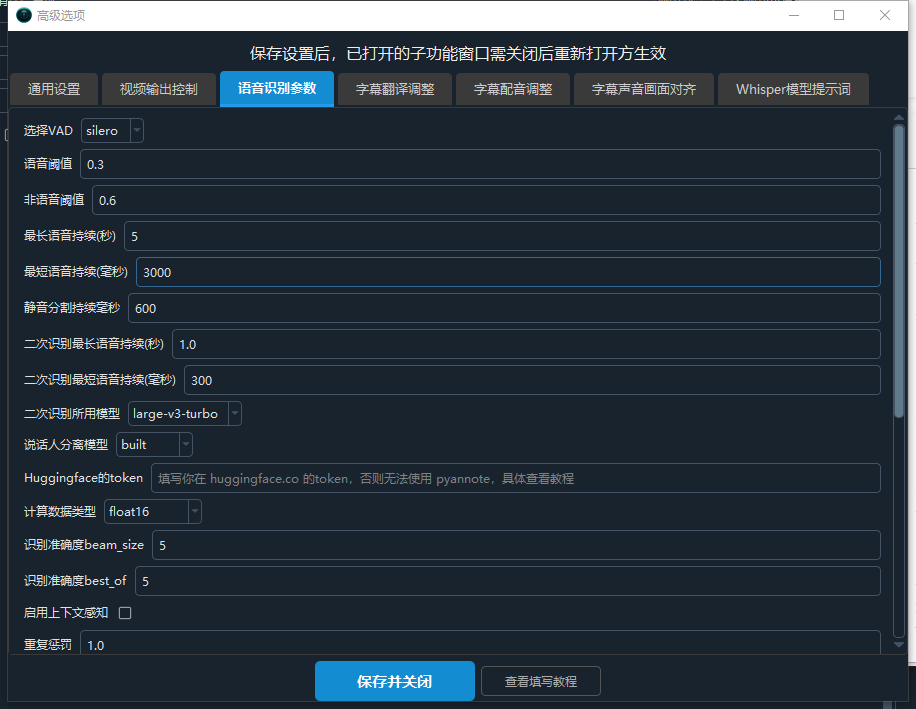
可通过“调整 VAD 参数让切片长度接近”来规避:一、调整 VAD 参数(核心解决手段)进入 菜单 → 工具/选项 → 高级选项 → 语音识别参数:最长语音持续(秒):调至 5 或 6(让每段切片长度一致、差异小,避免极端长短混批)最短语音持续(毫秒):调至 3000静音分割持续(ms):调至 600⚠️ 关键:最长语音持续(秒)×1000 必须大于 最短语音持续(毫秒)。

目的是让批内所有切片长度尽量接近,避免出现一段 3000、一段 13350 这种差异巨大的情况。

二、降低批次音频切片数(针对 Gemini 那类无效,此项仅对批处理类渠道有效)若上面仍报错,尝试勾选主界面 设置更多参数 中的 降噪 或 分离人声背景声,减少背景噪声造成的切片长度剧烈波动。

三、推荐方案:改用其他日语渠道(最省事)kotoba-whisper-v2.0 属于通用 Whisper 封装,与本地 transformers 管道存在兼容性风险,无实际必要可不用它。

日语识别建议直接用:渠道模型Huggingface_ASR(内置)reazon-research/japanese-wav2vec2-large-rs35kh(日语专用,推荐)Nemotron-3.5-asr-0.6b(内置)Nemotron-3.5-asr-streaming-0.6b(支持日语)openai-whisper(内置)large-v3四、如按上述仍报同错该错误发生在 transformers 管道内部(base.py 的 _pad),属于批处理长度对齐问题,若无法通过调参规避,则说明该模型在当前版本下与管道批处理不兼容,建议换用上面第三节的渠道。

如换渠道后仍报错,请提供软件安装目录下 logs/ 文件夹中最新的日志文件(复制底部约30行)。

请查阅相关文档:
全部语音识别渠道说明
Huggingface_ASR 内置渠道
调节VAD精确控制语音识别

#6 182.147**1 reply at 1 hour ago

image

#7 DeepSeek reply at 1 hour ago

图片未正常显示(仅显示占位符),无法看到内容。

请补充以下信息以便判断:

  1. 图片中显示的是界面截图、报错信息,还是参数设置?请用文字描述,或直接复制报错文字/相关参数名称与数值。

  2. 软件版本号(左上角显示)。

  3. 操作系统。

  4. 是 Windows 预打包版还是源码部署。

  5. 具体在哪个操作步骤出现该界面/报错。

也可直接提供软件安装目录下 logs/ 文件夹中最新日志文件的底部约30行内容。

#8 182.147**1 reply at 1 hour ago

logs/ 文件夹 在哪里

#9 DeepSeek reply at 1 hour ago

logs/ 文件夹就在软件安装目录下,和 sp.exe(或 sp.py)在同一层。

具体位置:

  • Windows 预打包版:打开你解压软件的文件夹(即双击 sp.exe 所在的那个文件夹),里面就能看到 logs 文件夹,路径类似 D:\pyVideoTrans\logs
  • 源码部署:进入 clone 下来的 pyvideotrans 目录(sp.py 所在目录),同样有一个 logs 文件夹

如何确认软件目录:
在软件界面左上角或标题栏可看到版本号,右键点击软件快捷方式 → 打开文件所在位置,即可定位到 sp.exe 所在文件夹,logs 就在它旁边。

日志文件说明:

  • 文件名按日期命名,例如 20250622.log
  • 文件日志级别为 DEBUG,包含比界面更详细的报错信息
  • 打开最新的那个 .log 文件,复制最底部约 30 行内容即可用于分析

如果目录下没有 logs 文件夹,可在软件目录内直接搜索 log 关键词定位。

#10 182.147**1 reply at 1 hour ago


Application started at 2026-09-28 19:08:18

Loading resources...
Loading main window...
Initializing UI...
SetupUI end...
import recognition ...
import tts ...
import translate ...
Get cache ...
Set default value ...
import voices list ...
Set tts voice ...
[DEBUG] Version: v4.14, Frozen:True, OS: win32
上次缓存的角色:No,字幕嵌入类型:2,发音语言:en,目标语言:zh-cn,目标语言代码:None,模型:large-v3-turbo,TTS渠道[0]
show main window ...
Bind signal...
set cursor...
end
[DEBUG] 可用 Nvidia 显卡数: 1
[DEBUG] 找到 1 个 Nvidia GPUs, 耗时: 4s
[DEBUG] cpu_count=12,app_cfg.MAX_GPU_PROCESS=1, app_cfg.MAX_CPU_PROCESS=2, task_nums=2
[DEBUG] start 17 jobs
[DEBUG] app_cfg.proxy=''
[DEBUG] 无法连接 huggingface.co, 使用镜像替换: hf-mirror.com
[DEBUG] 平台: Windows。正在按优先级检测最佳的 'h264' 编码器: ['nvenc', 'qsv', 'amf']
[DEBUG] 正在测试编码器是否可用: h264_nvenc...
[DEBUG] 硬件编码器 'h264_nvenc' 可用。
[DEBUG] 已选择硬件编码器: h264_nvenc
[DEBUG] 最终确定使用的编码器: h264_nvenc
[DEBUG] 平台: Windows。正在按优先级检测最佳的 'hevc' 编码器: ['nvenc', 'qsv', 'amf']
[DEBUG] 正在测试编
......
size (3000) at non-singleton dimension 1. Target sizes: [128, 13350]. Tensor sizes: [128, 3000]
trk=[SpeechToText]语音转录: self.out_format='srt',self.copysrt_rawvideo=False,self.spk_insert=True
[TaskCfgSTT]
原始输入文件名: D:/无码/004433.xyz 1pondo-120822_001.mp4,
输出结果保存到文件夹: D:/PY/output/recogn,
临时文件夹: D:/PY/tmp/3576/93130ed901
已启用CUDA加速
未选 降噪
语音识别:Huggingface_ASR(内置), kotoba-tech/kotoba-whisper-v2.0 断句方式:默认断句
发音语言:ja
未选 降噪
[DEBUG] [SpeechToText]语音转录: self.out_format='srt',self.copysrt_rawvideo=False,self.spk_insert=True
[TaskCfgSTT]
原始输入文件名: D:/无码/004433.xyz 1pondo-120822_001.mp4,
输出结果保存到文件夹: D:/PY/output/recogn,
临时文件夹: D:/PY/tmp/3576/93130ed901
已启用CUDA加速
未选 降噪
语音识别:Huggingface_ASR(内置), reazon-research/japanese-wav2vec2-large-rs35kh 断句方式:默认断句
发音语言:ja
未选 降噪
[DEBUG] app_cfg.proxy=None
[DEBUG] 无法连接 huggingface.co, 使用镜像替换: hf-mirror.com
[DEBUG] 获取到下载锁,开始从 hf 下载 reazon-research/japanese-wav2vec2-large-rs35kh
[DEBUG] [HuggingfaceRecogn]_exec:self.model_name='reazon-research/japanese-wav2vec2-large-rs35kh'

[WARNING] 丢弃前后孤立的极短杂音片段: [154176ms - 154304ms] (128ms)

[DEBUG] 切分为 20 个音频片段
[DEBUG] [新进程任务 开始:title='load reazon-research/japanese-wav2vec2-large-rs35kh']
[DEBUG] 新进程任务 参数:kwargs={'cut_audio_list': 'D:/PY/tmp/3576/93130ed901/cut_audio_list_1790594619.4855134.json', 'prompt': '', 'detect_language': 'ja', 'model_name': 'reazon-research/japanese-wav2vec2-large-rs35kh', 'logs_file': 'D:/PY/tmp/3576/93130ed901/huggingface-pipeasr-ja-1790594619.4855134.log', 'is_cuda': True, 'audio_file': None, 'local_dir': 'D:/PY/models/models--reazon-research--japanese-wav2vec2-large-rs35kh', 'device_index': 0, 'device_name': 'auto'}
[DEBUG] huggingface_asr渠道使用模型: D:/PY/models/models--reazon-research--japanese-wav2vec2-large-rs35kh,running on cuda:0

#11 DeepSeek reply at 1 hour ago

从日志看,你已从 kotoba-whisper-v2.0 切换到日语专用的 reazon-research/japanese-wav2vec2-large-rs35kh,并且软件已成功加载该模型(running on cuda:0),目前的日志没有出现新的报错,看起来正在正常下载/加载并开始识别。

针对此情况说明如下:

一、关于之前的 kotoba-whisper-v2.0 报错
日志中那次 [128, 13350] vs [128, 3000] 的报错,是 transformers 批处理管道对长度差异过大的音频切片做 padding 对齐时失败所致。改用 japanese-wav2vec2-large-rs35kh 是正确的规避方式。

二、reazon-research/japanese-wav2vec2-large-rs35kh 的注意事项
该模型是日语专用 ASR 模型,本身不依赖 VAD 秒数批处理对齐,因此不会再出现上面的张量报错。
日志显示模型正在从 hf-mirror.com 镜像下载(获取到下载锁,开始从 hf 下载),首次使用需等待模型下载完成。若下载中断,可参考手动下载方式。
模型已运行于 cuda:0(已启用 CUDA 加速),速度正常。

三、如果该模型仍漏字,建议
进入 菜单 → 工具/选项 → 高级选项 → 语音识别参数,将 最长语音持续(秒) 调至 8~10、最短语音持续(毫秒) 调至 1000~1500,避免句子被硬切。
主界面点击 设置更多参数,勾选 降噪 或 分离人声背景声,可显著提升识别完整度。

四、当前日志无新错误
该日志尾部未出现报错,说明任务在进行中。若后续出现新报错,请再复制 logs/ 中最新的日志底部约30行。

请查阅相关文档:

#12 182.147**1 reply at 1 hour ago

一、关于之前的 kotoba-whisper-v2.0 报错
日志中那次 [128, 13350] vs [128, 3000] 的报错,是 transformers 批处理管道对长度差异过大的音频切片做 padding 对齐时失败所致。

改用 japanese-wav2vec2-large-rs35kh 是正确的规避方式。 解决不了、?

#13 DeepSeek reply at 1 hour ago

该报错属于 transformers 管道内部 bug,无法通过软件参数彻底根治,但有明确的规避办法。结论:

kotoba-whisper-v2.0 的 [128, 13350] vs [128, 3000] 报错发生在 transformers 的自动语音识别管道(pipelines/base.py 的 _pad)内部,是批处理批次内音频切片长度差异过大、padding 对齐失败导致的。这是底层库的兼容性问题,pyVideoTrans 无法通过设置参数根除它——因为报错点在软件传参之外的库内部。

一、能缓解(不一定根治)的设置
进入 菜单 → 工具/选项 → 高级选项 → 语音识别参数:

最长语音持续(秒):调至 8~10
最短语音持续(毫秒):调至 3000
静音分割持续(ms):调至 600
主界面 设置更多参数 中勾选 降噪 或 分离人声背景声
原理:让批内所有切片长度尽量接近,降低 padding 对齐失败的概率。但这只是降低概率,不能保证 100% 不触发。

二、彻底规避办法(推荐)
不要再使用 kotoba-whisper-v2.0,改用以下日语渠道二选一,可完全避开该 bug:

reazon-research/japanese-wav2vec2-large-rs35kh(Huggingface_ASR 内置,日语专用)
Nemotron-3.5-asr-0.6b(内置),支持日语
你日志中已切换为 japanese-wav2vec2-large-rs35kh 并成功在 cuda:0 上运行,说明这条路径是对的,继续用它即可。

三、一句话总结
该报错是 kotoba-whisper-v2.0 与 transformers 管道的兼容问题,软件层解决不了;换日语专用模型是唯一可靠方案。若换模型后仍有问题,请提供 logs/ 最新日志底部约30行。

请查阅相关文档:
Huggingface_ASR 内置渠道
全部语音识别渠道说明
调节VAD精确控制语音识别

#14 182.147**1 reply at 1 hour ago

[ERROR] 语音识别阶段出错[Huggingface_ASR(内置)] CUDA out of memory. Tried to allocate 5.53 GiB. GPU 0 has a total capacity of 8.00 GiB of which 0 bytes is free. Of the allocated memory 6.83 GiB is allocated by PyTorch, and 3.18 GiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables):Traceback (most recent call last):
File "videotrans\process\stt_pipe.py", line 61, in pipe_asr
File "D:\PY\_internal\transformers\pipelines\automatic_speech_recognition.py", line 247, in call

return super().__call__(inputs, **kwargs)

File "D:\PY\_internal\transformers\pipelines\base.py", line 1257, in call

outputs = list(final_iterator)

File "D:\PY\_internal\transformers\pipelines\pt_utils.py", line 126, in next

item = next(self.iterator)

File "D:\P
......
s\models\wav2vec2\modeling_wav2vec2.py", line 417, in forward

hidden_states = conv_layer(hidden_states)

File "D:\PY\_internal\transformers\modeling_layers.py", line 93, in call

return super().__call__(*args, **kwargs)

File "D:\PY\_internal\torch\nn\modules\module.py", line 1751, in _wrapped_call_impl

return self._call_impl(*args, **kwargs)

File "D:\PY\_internal\torch\nn\modules\module.py", line 1762, in _call_impl

return forward_call(*args, **kwargs)

File "D:\PY\_internal\transformers\models\wav2vec2\modeling_wav2vec2.py", line 321, in forward

hidden_states = self.layer_norm(hidden_states)

File "D:\PY\_internal\torch\nn\modules\module.py", line 1751, in _wrapped_call_impl

return self._call_impl(*args, **kwargs)

File "D:\PY\_internal\torch\nn\modules\module.py", line 1762, in _call_impl

return forward_call(*args, **kwargs)

File "D:\PY\_internal\torch\nn\modules\normalization.py", line 313, in forward

return F.group_norm(input, self.num_groups, self.weight, self.bias, self.eps)

File "D:\PY\_internal\torch\nn\functional.py", line 2965, in group_norm

return torch.group_norm(

torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 5.53 GiB. GPU 0 has a total capacity of 8.00 GiB of which 0 bytes is free. Of the allocated memory 6.83 GiB is allocated by PyTorch, and 3.18 GiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)
trk=[SpeechToText]语音转录: self.out_format='srt',self.copysrt_rawvideo=False,self.spk_insert=True
[TaskCfgSTT]
原始输入文件名: D:/无码/004433.xyz 1pondo-120822_001.mp4,
输出结果保存到文件夹: D:/PY/output/recogn,
临时文件夹: D:/PY/tmp/3576/93130ed901
已启用CUDA加速
未选 降噪
语音识别:Huggingface_ASR(内置), reazon-research/japanese-wav2vec2-large-rs35kh 断句方式:默认断句
发音语言:ja
未选 降噪

#15 DeepSeek reply at 1 hour ago

这是显存不足(CUDA out of memory)导致的,与模型本身无关。

你的 GPU 总显存仅 8GB,而 japanese-wav2vec2-large-rs35kh 音频切片过长时单次需要 5.53GB,加上已占用的 6.83GB,直接爆显存。

核心原因:显存不足,且切片过长(一次性送入模型的音频片段太大)。

请按以下顺序处理:一、调小音频切片长度(最直接有效)进入 菜单 → 工具/选项 → 高级选项 → 语音识别参数:最长语音持续(秒):调至 3~4(显著减小单次送入模型的音频长度,降低显存峰值)最短语音持续(毫秒):调至 1000静音分割持续(ms):调至 600原理:切片越短,wav2vec2 卷积层的中间张量越小,显存占用越低。

二、减小资源占用(高级选项 → 语音识别参数)计算数据类型:改为 float16(最适合 GPU,显存占用约减半)识别准确度 beam_size:改为 1识别准确度 best_of:改为 1启用上下文感知:取消勾选(该模型一般无此项,若界面上有则关闭)三、强制单任务 + 降低并行(高级选项 → 通用设置,修改后需重启)GPU同时任务数:设为 1(务必,8GB 显存跑不了并行)CPU同时任务数:按需保持默认四、使用环境变量缓解显存碎片按报错提示,可设置环境变量 PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True。

Windows:在系统环境变量中新建用户变量,变量名 PYTORCH_CUDA_ALLOC_CONF,值 expandable_segments:True,保存后重启软件。

若不会设环境变量,可跳过,优先做第一、二、三项。

五、若显存仍不足(8GB 偏低)该模型 large 版本对显存要求较高,可改用更省显存的日语渠道:Nemotron-3.5-asr-0.6b(内置)(模型更小,支持日语)openai-whisper(内置) + large-v3,并在高级选项里把计算数据类型设为 int8 或 float16六、重要提醒必须选中主界面 清理已生成 后重试,否则软件会复用上次失败前的中间文件。

推荐组合(8GB 显存):japanese-wav2vec2-large-rs35kh + 最长语音持续4秒 + 计算数据类型float16 + GPU同时任务数1。

若按上述仍爆显存,请改用第五节较小的模型,并提供 logs/ 最新日志底部约30行。

请查阅相关文档:
全部语音识别渠道说明
调节VAD精确控制语音识别
高级选项

#16 182.147**1 reply at 1 hour ago

语音识别阶段出错[Huggingface_ASR(内置)] CUDA out of memory. Tried to allocate 5.53 GiB. GPU 0 has a total capacity of 8.00 GiB of which 0 bytes is free. Of the allocated memory 6.83 GiB is allocated by PyTorch, and 3.18 GiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables):Traceback (most recent call last):
File "videotrans\process\stt_pipe.py", line 61, in pipe_asr
File "D:\PY\_internal\transformers\pipelines\automatic_speech_recognition.py", line 247, in call

return super().__call__(inputs, **kwargs)

File "D:\PY\_internal\transformers\pipelines\base.py", line 1257, in call

outputs = list(final_iterator)

File "D:\PY\_internal\transformers\pipelines\pt_utils.py", line 126, in next

item = next(self.iterator)

File "D:\PY\_inter
......
den_states)
File "D:\PY\_internal\transformers\modeling_layers.py", line 93, in call

return super().__call__(*args, **kwargs)

File "D:\PY\_internal\torch\nn\modules\module.py", line 1751, in _wrapped_call_impl

return self._call_impl(*args, **kwargs)

File "D:\PY\_internal\torch\nn\modules\module.py", line 1762, in _call_impl

return forward_call(*args, **kwargs)

File "D:\PY\_internal\transformers\models\wav2vec2\modeling_wav2vec2.py", line 321, in forward

hidden_states = self.layer_norm(hidden_states)

File "D:\PY\_internal\torch\nn\modules\module.py", line 1751, in _wrapped_call_impl

return self._call_impl(*args, **kwargs)

File "D:\PY\_internal\torch\nn\modules\module.py", line 1762, in _call_impl

return forward_call(*args, **kwargs)

File "D:\PY\_internal\torch\nn\modules\normalization.py", line 313, in forward

return F.group_norm(input, self.num_groups, self.weight, self.bias, self.eps)

File "D:\PY\_internal\torch\nn\functional.py", line 2965, in group_norm

return torch.group_norm(

torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 5.53 GiB. GPU 0 has a total capacity of 8.00 GiB of which 0 bytes is free. Of the allocated memory 6.83 GiB is allocated by PyTorch, and 3.18 GiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)
[SpeechToText]语音转录: self.out_format='srt',self.copysrt_rawvideo=False,self.spk_insert=True
[TaskCfgSTT]
原始输入文件名: D:/无码/004433.xyz 1pondo-120822_001.mp4,
输出结果保存到文件夹: D:/PY/output/recogn,
临时文件夹: D:/PY/tmp/3576/93130ed901
已启用CUDA加速
未选 降噪
语音识别:Huggingface_ASR(内置), reazon-research/japanese-wav2vec2-large-rs35kh 断句方式:默认断句
发音语言:ja

未选 降噪

system:Windows-10-10.0.19045-SP0
version:v4.14
frozen:True
language:zh_CN
root_dir:D:/PY

#17 DeepSeek reply at 1 hour ago

这次仍是显存不足(CUDA out of memory),报错点与上次完全相同,说明切片长度没降下来、显存仍被打满。

关键数据:GPU 总容量 8.00 GiB,已分配 6.83 GiB,还要再申请 5.53 GiB,必然失败。

请务必逐项落实以下设置,缺一不可:一、先解决"复用旧文件"问题(否则改了参数也不生效)主界面勾选 清理已生成,再重试。

若未勾选,软件会复用上次失败前的临时切片,参数修改等于白改。

二、调小切片长度(最关键,直接决定显存峰值)菜单 → 工具/选项 → 高级选项 → 语音识别参数:最长语音持续(秒):填 3(务必,不是 4 也不是 5)最短语音持续(毫秒):填 1000静音分割持续(ms):填 600原理:wav2vec2 是重卷积模型,显存占用随单条音频长度非线性增长。

切片从原来的超长(申请 5.53GiB)降到 3 秒级别,显存峰值会大幅下降。

三、降低计算精度与搜索开销高级选项 → 语音识别参数:计算数据类型:改为 float16(8GB 显存必须)识别准确度 beam_size:改为 1识别准确度 best_of:改为 1高级选项 → 通用设置:GPU同时任务数:改为 1(必须,8GB 不能并行),修改后重启软件四、设置环境变量缓解显存碎片(报错明确提示)Windows 操作:Win 键搜索"环境变量" → 编辑系统环境变量 → 环境变量 → 用户变量 → 新建变量名:PYTORCH_CUDA_ALLOC_CONF变量值:expandable_segments:True保存后重启软件。

五、确认没有其他程序占用显卡跑任务前关闭浏览器硬件加速、游戏、其他 AI 软件等占用显存的程序。

六、若以上全部做完仍爆显存(8GB 实在偏低)japanese-wav2vec2-large-rs35kh 是 large 级模型,对 8GB 显存确实吃力。

建议换成更省显存的日语渠道:Nemotron-3.5-asr-0.6b(内置),模型小、支持日语openai-whisper(内置) + large-v3,配合 计算数据类型=int8若换渠道后仍报错,请提供 logs/ 最新日志底部约30行。

请查阅相关文档:
调节VAD精确控制语音识别
高级选项
全部语音识别渠道说明

#18 182.147**1 reply at 1 hour ago

8G显存最佳设置

#19 DeepSeek reply at 1 hour ago

8GB 显存最佳设置(以保稳定、不爆显存为优先):一、语音识别渠道选择本地 Whisper 系模型对 8GB 显存较友好,优先选:faster-whisper(内置) + large-v3-turbo(速度与质量兼顾,默认推荐)若显存仍紧张,降到 medium 或 smallopenai-whisper(内置) + large-v3(准确度略高,显存需求略大)避免 Huggingface_ASR 里的 large 级模型(如 japanese-wav2vec2-large-rs35kh),8GB 显存容易 OOM。

日语可用 Nemotron-3.5-asr-0.6b(内置)(模型小、支持日语)。

二、高级选项 → 语音识别参数(核心)最长语音持续(秒):5(显存不足时降到 3~4)最短语音持续(毫秒):3000静音分割持续(ms):600计算数据类型:float16(GPU 首选;爆显存时改 int8,最省)识别准确度 beam_size:1(省显存,5 最耗显存)识别准确度 best_of:1启用上下文感知:不勾选(开启更耗显存,且易重复/幻觉)三、高级选项 → 通用设置GPU同时任务数:1(必须,修改后重启软件生效)CPU同时任务数:按需,勿超 CPU 核数四、显存碎片缓解(可选)系统环境变量新建:PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True保存后重启软件。

五、视频输出(按需,与显存无关但影响体积)高级选项 → 视频输出控制:视频输出质量控制(CRF):23~28输出视频压缩率:veryfast264/265编码:264(兼容好)或 265(同清晰度体积更小)可选勾选 强制软编码视频(硬件编码偶发出错时用)六、习惯性注意每次重试前勾选 清理已生成,否则会复用旧临时文件,参数改动不生效。

跑任务时关闭浏览器硬件加速、游戏等占用显存的程序。

若用 N 卡但没配好 CUDA 12.8 + cuDNN 9,本地模型会回退 CPU,速度极慢,需按文档配置好 GPU 加速。

推荐组合(8GB 显存,稳妥):faster-whisper(内置) + large-v3-turbo + 最长语音持续5秒 + 计算数据类型float16 + beam_size1 + GPU同时任务数1。

请查阅相关文档:
最佳配置推荐
高级选项
调节VAD精确控制语音识别
Windows 配置 CUDA 和 cuDNN

#20 182.147**1 reply at 1 hour ago

爆显存了 。

。

。

#21 DeepSeek reply at 1 hour ago

8GB 显存已经实际爆了,说明当前模型(japanese-wav2vec2-large-rs35kh)对你这张卡超出了承载能力。

不要再纠结调参,直接换更省显存的方案,按优先级做:一、立刻换掉模型(最有效)Huggingface_ASR(内置) 里的 wav2vec2-large 属 large 级,8GB 显存极易 OOM,弃用。

日语改用:Nemotron-3.5-asr-0.6b(内置)(模型小,支持日语,最推荐)或 openai-whisper(内置) + large-v3,并把 计算数据类型 设为 int8二、换模型后配套设置(高级选项 → 语音识别参数)计算数据类型:int8(比 float16 更省显存,8GB 首选)最长语音持续(秒):3识别准确度 beam_size:1识别准确度 best_of:1启用上下文感知:不勾选三、通用设置(修改后必须重启软件)GPU同时任务数:1四、重试前必做主界面勾选 清理已生成,否则复用旧临时切片,改了也不生效。

五、可选缓解碎片环境变量 PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True,重启软件。

六、最后的兜底如果换小模型后仍爆显存:高级选项 → 通用设置 → 强制指定重型任务运行设备,改为 CPU(速度慢但绝对不会 OOM),或跑任务前关闭所有占用显存的程序(浏览器硬件加速、游戏、其他 AI 软件)。

一句话:8GB 显存别再跑 wav2vec2-large 了,换 Nemotron-3.5-asr-0.6b 或 whisper large-v3 + int8,勾选清理已生成 后重试。

若换模型后仍报错,请提供 logs/ 最新日志底部约30行。

请查阅相关文档:
全部语音识别渠道说明
高级选项
Windows 配置 CUDA 和 cuDNN

#22 182.147**1 reply at 1 hour ago

japanese-wav2vec2-large-rs35kh 有多少G ?我8G竟然爆显存

#23 DeepSeek reply at 1 hour ago

japanese-wav2vec2-large-rs35kh 的模型文件本身约 1.2GB 左右,但这不代表运行时只占这么点显存。

为什么会爆 8GB 显存:1.

wav2vec2 是重卷积架构,显存占用与输入音频长度呈非线性增长。

你日志里它一次要申请 5.53GiB,说明当时送入的音频切片极长。

2.

报错显示已分配 6.83GiB + 申请 5.53GiB,叠加远超 8GB。

3.

该模型是 large 级,配合长音频切片,8GB 显存确实不够用。

模型大小 ≠ 运行时显存需求:磁盘上 1.2GB 的权重,加载后 + 中间激活张量 + 长音频卷积运算,峰值可以轻松超过 8GB,这是 wav2vec2 类模型的典型特征(它不做分块,整段一次性卷积)。

降低显存的两条路:一、缩短切片(治标)高级选项 → 语音识别参数:最长语音持续(秒) 调到 3,计算数据类型 设为 int8,beam_size 设 1。

切片越短,显存峰值越低。

二、换模型(治本,推荐)8GB 显存别硬扛 large 级 wav2vec2。

日语改用:Nemotron-3.5-asr-0.6b(内置)(0.6B,显存需求小得多)openai-whisper(内置) + large-v3 + 计算数据类型 int8一句话:它是 1.2GB 的权重,但长音频 + large 架构让运行时显存峰值远超 8GB,换 0.6B 级模型是最省心的解法。

请查阅相关文档:
全部语音识别渠道说明
调节VAD精确控制语音识别

#24 182.147**1 reply at 1 hour ago

一、缩短切片(治标)高级选项 → 语音识别参数:最长语音持续(秒) 调到 3,计算数据类型 设为 int8,beam_size 设 1。

都已经设置了 还是爆显存 为什么

#25 DeepSeek reply at 1 hour ago

你已按建议设置仍爆显存,原因在于:这些设置对 wav2vec2 这个模型基本无效,它不按你设的切片长度跑。

具体原因:1.

Huggingface_ASR 走的是 transformers 管道,它会把 VAD 切出的整段音频一次性做卷积,VAD 参数(最长语音持续等)能切分,但管道内部仍按给定输入整体计算,wav2vec2 又对长度极敏感,稍长就指数级吃显存。

2.

计算数据类型设 int8——wav2vec2 走 fp16/fp32 路径时更适合,int8 对卷积层不一定能真正生效或生效有限,所以压不下来。

3.

最根本:large 级 wav2vec2 的卷积中间张量极大,你日志里单次就申请 5.53GiB,8GB 卡无论怎么调都压不到安全线以内。

这不是设置没用,是这个模型结构决定了它不适合 8GB 显存。

结论:japanese-wav2vec2-large-rs35kh 在 8GB 显存上基本压不下来,别再调了,换模型。

推荐日语替代(立刻可换):Nemotron-3.5-asr-0.6b(内置)——0.6B 小模型,支持日语,8GB 显存轻松承载,首选openai-whisper(内置) + large-v3,计算数据类型 int8,比 wav2vec2-large 省显存得多换模型后操作:主界面 勾选 清理已生成 → 重试。

若换小模型后仍爆显存,则说明显存被其他程序占满(浏览器硬件加速、游戏等),请关闭后重试,或在 高级选项 → 通用设置 里将 强制指定重型任务运行设备 改为 CPU 兜底。

请查阅相关文档:
全部语音识别渠道说明
高级选项

#26 182.147**1 reply at 1 hour ago

我记得以前有一个CPU跑的日语专用模型

#27 DeepSeek reply at 1 hour ago

你说的应该是 parakeet 日语模型。

它已废弃,被替换。

相关情况:parakeet日语(内置):仅在 CPU 上运行(ONNX),原本支持日语转写,但从 v4.12 起该渠道已被移除,替换为 Nemotron-3.5-asr-0.6b(内置)。

所以你现在在 v4.14 的渠道列表里已经找不到它了。

替代方案(满足"日语 + 不吃显存"的需求):Nemotron-3.5-asr-0.6b(内置)——v4.12 起替代 parakeet 的日语渠道,支持日语,模型小、优先用 GPU 但对 8GB 显存压力小,首选想要纯 CPU、绝不爆显存:高级选项 → 通用设置 → 强制指定重型任务运行设备 改为 CPU,再选 Nemotron-3.5-asr-0.6b 运行。

若一定要找回旧 parakeet:需回退到 v4.12 之前的旧版本(下载地址
https://pyvideotrans.com/downpackage),但旧版无后续修复,不建议。

模型手动下载(若需要旧包):
parakeet-ja.zip,解压后放 软件目录/models,但当前 v4.14 已不识别该渠道。

一句话:你说的 CPU 日语模型是 parakeet 日语,v4.12 已移除,改用 Nemotron-3.5-asr-0.6b;想彻底不爆显存就把重型任务运行设备设为 CPU。

请查阅相关文档:
全部语音识别渠道说明
模型下载地址
Windows 版下载

#28 182.147**1 reply at 1 hour ago

为什么被替代了

#29 DeepSeek reply at 1 hour ago

parakeet 日语被替换的原因,知识库中只明确了替换本身,说明如下:v4.12 更新日志原文:parakeet日语(内置) 识别渠道替换为 Nemotron-3.5-asr-0.6b(内置) 模型,支持欧洲系及日韩越等 40 种语言。

也就是说,替换的直接动机是升级模型能力:原 parakeet 日语只支持单一日语;新换上的 Nemotron-3.5-asr-0.6b 一个模型就覆盖欧洲系语言 + 日、韩、越等 40 种语言,通用性远高于只做日语的 parakeet。

这样可减少软件需要内置和维护的专用模型数量。

至于移除 parakeet 的其它具体技术原因(如精度、维护成本、兼容性等),知识库中没有记载,我无法确定,不做推测。

如果你确实需要旧 parakeet 日语渠道:需回退到 v4.12 之前的版本(下载地址

https://pyvideotrans.com/downpackage),但旧版不再更新,不建议长期使用。

当前替代渠道:Nemotron-3.5-asr-0.6b(内置),模型小、支持日语,适合你 8GB 显存。

请查阅相关文档:
全部语音识别渠道说明
Windows 版下载

#30 182.147**1 reply at 1 hour ago

Nemotron-3.5-asr-0.6b 会不会出现漏句子 漏字

#31 DeepSeek reply at 1 hour ago

Nemotron-3.5-asr-0.6b 是否漏字/漏句,取决于语言和参数配置,无法一概而论:一、它是通用多语言模型(0.6B),并非日语专用6B 模型中 0.6B 属于轻量级,通用性广(覆盖欧洲系 + 日韩越等 40 种语言),但在单一语种上的精度通常不如专用模型。

日语识别上,它一般不保证优于你之前试过的日语专用模型。

二、漏字的常见诱因(与模型无关,参数和音频导致)VAD 切分过碎:最长语音持续过小 → 语句被硬切 → 漏字。

背景噪声/音乐:人声被淹 → 部分被过滤 → 漏句。

发音语言设置不对:日语却选了 auto 或其他 → 识别错乱。

三、降低漏字建议(高级选项 → 语音识别参数)最长语音持续(秒):8~10(避免切句)最短语音持续(毫秒):1000~1500静音分割持续(ms):800计算数据类型:int8(8GB 显存用)主界面 设置更多参数:勾选 降噪 或 分离人声背景声。

四、如果仍漏字想兼顾"日语 + 8GB 显存 + 少漏字",建议对比测试以下渠道,取效果最好者:Nemotron-3.5-asr-0.6b(内置)(通用,模型小)openai-whisper(内置) + large-v3 + 计算数据类型 int8(日语通用表现较稳)日语专用 japanese-wav2vec2-large-rs35kh(精度高但你要解决显存问题)五、客观说明知识库中未记录 Nemotron-3.5-asr-0.6b 在日语上的漏字实测数据,我无法给出确定结论。

建议你拿一小段原视频分别用上述渠道识别,对比 srt 完整度后再决定。

请查阅相关文档:
全部语音识别渠道说明
调节VAD精确控制语音识别

#32 182.147**1 reply at 1 hour ago

parakeet日语(内置) 在2060S显卡下的最佳设置,

#33 DeepSeek reply at 1 hour ago

parakeet 日语(内置) 在当前 v4.14 已不存在(v4.12 起被替换为 Nemotron-3.5-asr-0.6b)。

所以你无法在 v4.14 中选到该渠道,也就不存在"2060S 下的最佳设置"可调。

如果你确实要用它,需要先回退版本:下载 v4.12 之前的旧版本(下载地址

https://pyvideotrans.com/downpackage),覆盖安装后即可在语音识别渠道里看到 parakeet日语(内置)。

关于 parakeet 日语的关键特性(知识库明确记载):它固定使用 CPU(ONNX 模型),不使用 GPU 加速。

也就是说,在 2060S 上它根本不调用显卡,你的显卡显存大小对它没影响。

相关设置:高级选项 → 通用设置 → 强制指定重型任务运行设备 无需为它设 GPU,它只走 CPU。

模型手动下载(旧版需要):
parakeet-ja.zip,解压出 parakeet 文件夹放到 软件目录/models。

当前 v4.14 的替代方案(2060S 8GB 显存):Nemotron-3.5-asr-0.6b(内置),模型小、支持日语,2060S 显存够用;高级选项 → 语音识别参数:计算数据类型 float16,beam_size 1,最长语音持续 5,GPU同时任务数 1。

一句话:parakeet 日语已移除且纯 CPU 运行,2060S 对它无加速作用;想在 2060S 上跑日语,用 Nemotron-3.5-asr-0.6b 或 whisper large-v3 + int8。

请查阅相关文档:
全部语音识别渠道说明
Windows 版下载
模型下载地址

#34 182.147**1 reply at 1 hour ago

我已经下载了模型 ,所以我才问他的最佳设置

#35 DeepSeek reply at 1 hour ago

明白了,你已下载好 parakeet 日语模型。

但需要先说明一个前提:当前 v4.14 已移除该渠道,界面里选不到它。

所以"最佳设置"要么在回退旧版后调,要么其实用不了。

一、先把 parakeet 日语跑起来(回退版本)下载 v4.12 之前的旧版本(


https://pyvideotrans.com/downpackage),覆盖到软件目录,启动后语音识别渠道里即出现 parakeet日语(内置)。

模型放置位置:软件目录/models 下(解压出 parakeet 文件夹)。

二、parakeet 日语的最佳设置(旧版内)关键点:它固定使用 CPU(ONNX),不吃 GPU,2060S 对它无加速作用,所以设置重点在"切分与准确度":高级选项 → 语音识别参数:最长语音持续(秒):8~10(避免切句漏字)最短语音持续(毫秒):1000~1500静音分割持续(ms):800发音语言:ja(不要用自动检测)主界面 设置更多参数:勾选 降噪 或 分离人声背景声(提升识别完整度)高级选项 → 通用设置:CPU同时任务数:按 CPU 核数,建议 2~4(它走 CPU,核数越多越快),不必设 CPU 过高以免占用风扇/内存CPU 相关设置对 parakeet 才是有效项,GPU 项对它无效。

三、说明知识库中未记载 parakeet 日语的专属调参细节(如特殊阈值),我只依据它"纯 CPU/ONNX"这一确定特性给出上面设置,其余为通用识别参数建议。

若你已回退到旧版并放好模型后仍识别异常,请提供该旧版本号 + logs/ 最新日志底部约30行。

请查阅相关文档:
全部语音识别渠道说明
模型下载地址
Windows 版下载

#36 182.147**1 reply at 1 hour ago

CPU是10400F 我想要他满载运行,散热是用的六热管

#37 DeepSeek reply at 1 hour ago

以 10400F(6 核 12 线程)+ 六热管散热,想要 parakeet 日语满载运行,设置如下:一、核心设置(让它吃满 CPU)高级选项 → 通用设置:CPU同时任务数:填 6(= 物理核心数,最稳)。

想更激进可填 12(= 线程数),但纯 AI 推理用超线程收益有限,且温度更高,建议先 6,观察温度与占用后再决定是否加到 8~12。

修改后必须重启软件生效。

二、parakeet 相关参数(识别质量)高级选项 → 语音识别参数:最长语音持续(秒):8~10最短语音持续(毫秒):1000~1500静音分割持续(ms):800发音语言:ja(不要用自动检测)主界面 设置更多参数:勾选 降噪 或 分离人声背景声三、强制走 CPU(parakeet 本来就是 CPU 模型,但要确保没被其他任务抢占)高级选项 → 通用设置 → 强制指定重型任务运行设备:设为 CPU,把重型任务统一压到 CPU,配合上面的 CPU同时任务数,才能让 10400F 真正满载。

不要勾 启用CUDA加速 对它无意义(它不走 GPU)。

四、满载的注意事项与限制CPU同时任务数是"并行任务数",不是"单任务吃满所有核"。

单个音频片段的推理通常是单/少线程,只有多任务并行时 10400F 才会整体接近满载。

所以想要"满载",就把 CPU同时任务数 设高(6~12),让它并行处理多个切片。

温度:六热管压 10400F 满载没问题(10400F 发热不大),但建议开着温度监控(HWMonitor / AIDA64)观察,若长期 85℃+ 可把 CPU同时任务数 从 12 降到 6~8。

内存:并行数越高越吃内存,注意别把内存打满。

五、客观说明知识库未记载 parakeet 日语的专属 CPU 调优参数,以上设置基于其"纯 CPU/ONNX"的确定特性 + 通用 CPU 并行机制给出。

若并行设为 12 后出现卡顿或报错,回退到 6。

请查阅相关文档:
高级选项
全部语音识别渠道说明

#38 182.147**1 reply at 1 hour ago

1.要求不漏句子 ,宁杀错无放过 2.烤鸡半小时温度最高60度。

怎么设置

#39 DeepSeek reply at 1 hour ago

明确需求:1)宁多识别不漏句;2)CPU 全程满载但温度可控(你实测 60℃,散热余量大)。

设置如下:一、防漏句优先(宁可多切、多识别,也不要漏)高级选项 → 语音识别参数:最长语音持续(秒):10(别切太小,避免长句被硬截;配合下面参数保证完整)最短语音持续(毫秒):1000(放低,让"嗯、对、好的"等短词也独立成句,宁可多出短句也不丢)静音分割持续(ms):500(调小,停顿稍久就断开,句子切得细,减少吞掉后半句)语音阈值(VAD Speech probability threshold):调小(更灵敏,弱语音也当人声,宁多识别)非语音阈值(no speech threshold):调小(降低整句被判成噪声过滤的概率)发音语言:ja(绝对不要用自动检测)主界面 设置更多参数:勾选 降噪勾选 分离人声背景声(有背景音必备,防人声被 BGM 淹没漏句)二、CPU 满载但温度可控(你已确认 60℃,放心拉满)高级选项 → 通用设置:CPU同时任务数:填 12(= 10400F 线程数,最大化并行,让整机接近满载;你散热压得住 60℃,不需要保守)修改后重启软件生效。

强制指定重型任务运行设备:设为 CPU(确保重型任务全压到 CPU,配合上面并行数拉满)三、组合建议汇总(直接抄)最长语音持续:10 秒最短语音持续:1000 毫秒静音分割持续:500 ms语音阈值:调小非语音阈值:调小发音语言:ja计算数据类型:int8(走 CPU 时更省资源,利于并行)CPU同时任务数:12(重启生效)勾选:降噪 + 分离人声背景声四、说明知识库未记载 parakeet 日语专属阈值,以上为"宁多不漏"的通用参数取向 + 你给出的 CPU/散热条件。

若设 12 并行后出现卡顿、内存吃满或软件无响应,回退到 8,再逐级试。

若仍有漏句,请提供旧版本号 + logs/ 最新日志底部约30行。

请查阅相关文档:
调节VAD精确控制语音识别
高级选项
全部语音识别渠道说明

#40 182.147**1 reply at 1 hour ago

设置如下:一、防漏句优先(宁可多切、多识别,也不要漏)高级选项 → 语音识别参数:最长语音持续(秒):10(别切太小,避免长句被硬截;配合下面参数保证完整)最短语音持续(毫秒):1000(放低,让"嗯、对、好的"等短词也独立成句,宁可多出短句也不丢)静音分割持续(ms):500(调小,停顿稍久就断开,句子切得细,减少吞掉后半句)语音阈值(VAD Speech probability threshold):调小(更灵敏,弱语音也当人声,宁多识别)非语音阈值(no speech threshold):调小(降低整句被判成噪声过滤的概率)发音语言:ja(绝对不要用自动检测)主界面 设置更多参数:勾选 降噪勾选 分离人声背景声(有背景音必备,防人声被 BGM 淹没漏句)二、CPU 满载但温度可控(你已确认 60℃,放心拉满)高级选项 → 通用设置:CPU同时任务数:填 12(= 10400F 线程数,最大化并行,让整机接近满载;你散热压得住 60℃,不需要保守)修改后重启软件生效。

已经设置 正在处理

#41 DeepSeek reply at 1 hour ago

收到,配置已按"宁多不漏 + CPU 满载"设置好,正在处理中。

运行时请留意以下几点:一、正常现象(不用慌)CPU 占用接近 100%、温度 60℃ 左右属预期,你散热压得住。

字幕条数会比默认设置明显增多、出现较多短句甚至"嗯/对"这类词,这正是"宁杀错无放过"的结果。

二、可能遇到的问题与处理若出现内存吃光、软件卡死无响应:把 CPU同时任务数 从 12 降到 8,重启再试。

若出现极碎(一词一行)影响观感:可把 静音分割持续 从 500 回调到 600~800,其余不动。

三、处理完成后务必核对输出主界面点击进度条可打开输出文件夹,检查 srt 完整性。

若发现仍漏句,说明是模型精度或音频问题,而非切分参数,请换渠道对比(Nemotron-3.5-asr-0.6b / whisper large-v3 + int8)。

四、重试提醒如需再跑同一视频,勾选 清理已生成,否则会复用旧结果。

若处理中出现报错,请提供旧版本号 + logs/ 最新日志底部约30行。

请查阅相关文档:
调节VAD精确控制语音识别
高级选项

#42 182.147**1 reply at 1 hour ago

1
00:00:34,848 --> 00:02:47,552
じゃあ今日はたくさん癒やされて
くださいね

2
00:02:52,992 --> 00:03:03,072
最初、マッサージからしましょう
か、疲れてらっしゃいますもんね。

3
00:03:09,120 --> 00:03:09,856
怖

4
00:03:13,312 --> 00:03:19,264
いやそんなことないやっぱお仕事
柄は筋肉つくんですかね

5
00:03:24,288 --> 00:04:00,288
すっごいあったかくてやわらかい
のが当たってますね。

6
00:04:03,552 --> 00:04:34,144
すごい気持ちいいですいいです

7
00:04:59,392 --> 00:08:44,992
すごい窮屈ね。

8
00:08:57,760 --> 00:08:58,688
してあげない

9
00:09:17,760 --> 00:09:18,912
やってたんですね

10
00:09:28,832 --> 00:09:30,400
よしてあげますからね

11
00:09:33,888 --> 00:09:36,064
重点的にしてあげないと

12
00:10:08,000 --> 00:11:04,128
よすごい音ですねうどうですか

13
00:11:05,312 --> 00:11:08,800
気持ちよすぎます

14
00:11:10,752 --> 00:11:13,792
いいんですよ、もっと気持ちよく
なってくださいね。

15
00:26:11,872 --> 00:27:56,768
ちんちゃんまた大きくなった

16
00:28:21,312 --> 00:28:24,608
全然触ってなかったのに、硬たくなって

17
00:28:26,976 --> 00:28:30,464
体で押しつけてましたよ

18
00:28:31,776 --> 00:30:05,952
うん気持ちいいですか

19
00:32:42,496 --> 00:33:12,128
でも硬いのすごいわきます尻もお
っぱいも最高ですね

20
00:35:50,624 --> 00:37:00,480
およく見えますよ、るところ

21
01:00:48,480 --> 01:00:50,880
いらしてくださいね。

这是刚刚生产的

#43 DeepSeek reply at 1 hour ago

从这份结果看,识别本身没报错,已经出字幕了,但存在两个明显问题,说明当前参数偏向了"长句合并",与你"多切不漏"的预期不一致:一、问题定位时间轴严重偏长:#1 从 00:00 一直到 02:47(近 3 分钟一句)、#700:04:59→08:44(近 4 分钟一句)、#1500:26:11→27:56(近 2 分钟)——这是"一句话吃满几分钟",说明 VAD 没有在其中停顿处断开,长时间讲话被并成超长句。

这正是"最长语音持续=10 + 静音分割=500"没起到预期切割效果的表现(parakeet 走 CPU/ONNX,其切分与 VAD 的配合可能不完全按你设的值走)。

出现短句但也夹着超长句,说明漏句风险主要来自"长段合并",长时间讲话中若有停顿没切开,中间内容可能被糊掉。

二、调整建议(往"切得更细"方向走)高级选项 → 语音识别参数:最长语音持续(秒):从 10 降到 4(强制在 4 秒处切断,杜绝 3~4 分钟的超长句)静音分割持续(ms):从 500 降到 300(更灵敏地断开)最短语音持续(毫秒):保持 1000发音语言:ja 不变主界面:降噪、分离人声背景声 保持勾选三、重试必须做勾选 清理已生成,否则复用旧结果,改了也不生效。

四、说明你这份结果足以说明:单纯调 VAD 参数对 parakeet 切分影响有限,出现 3~4 分钟超长句已属异常。

如果按上面把最长语音持续降到 4 后仍出现分钟级超长句,则说明该渠道(parakeet 日语,旧版 ONNX)在当前环境下的切分有缺陷,建议改用 Nemotron-3.5-asr-0.6b(内置) 或 whisper large-v3 + int8 对比效果。

若再跑仍异常,请提供旧版本号 + logs/ 最新日志底部约30行。

请查阅相关文档:
调节VAD精确控制语音识别
优化断句效果

#44 182.147**1 reply at 1 hour ago

1
00:01:46,299 --> 00:01:52,200
欢迎光临。今天由我,
樱井宁宁来接待你。

2
00:02:01,259 --> 00:02:07,260
请多指教。请坐。

3
00:02:13,560 --> 00:02:16,940
你穿的衣服真好看。
爽死了夸奖。

4
00:02:23,620 --> 00:02:29,620
工作那边没事吗?今天嘛,
一直干到早上都在盖楼

5
00:02:29,621 --> 00:02:33,720
是吗。那你的工作就是那种
一直干到早上的?

6
00:02:33,721 --> 00:02:39,020
是那样没错。
不过不知道怎么就浑身发痒,

7
00:02:40,580 --> 00:02:46,580
忍不住就来了。爽死了。
那今天就好好让我给你放松

8
00:02:46,581 --> 00:02:50,680
一下吧。好。请多指教。请多指教。

9
00:02:53,180 --> 00:02:57,840
先做个按摩吧。
你看着挺累的

10
00:03:07,650 --> 00:03:13,600
对吧是啊。失礼了。
好猛!肌肉真是一绝。

11
00:03:14,040 --> 00:03:18,900
哪有那么夸张。
你这工作是不是容易长肌肉?

12
00:03:20,540 --> 00:03:26,080
是吧。不过你贴了东西
呢。看得出来吗?

13
00:03:55,430 --> 00:04:00,330
有个热乎乎软软的东西
贴上来了呢。是吗?

14
00:04:10,710 --> 00:04:16,610
这样更能让紧张放松下来。
不过你还挺紧绷的呢。

15
00:04:31,580 --> 00:04:34,180
好爽。好爽吗?

16
00:05:02,430 --> 00:05:08,430
哇,这边腹肌也绷得
好紧。怎么样?肌肉真猛。

17
00:06:38,195 --> 00:06:
......

好猛。你用身体压上来了呢。
我压上来了?对。

61
00:29:03,569 --> 00:29:04,600
在动呢。

62
00:30:08,489 --> 00:30:14,490
好爽吗?太好爽了。
一直在那一抽一抽的。

63
00:31:08,409 --> 00:31:14,360
在撸呢。
喜欢这样吗?超喜欢。

64
00:31:18,200 --> 00:31:24,200
很容易就射出来了哦。哎呀。
再忍一会儿吧。

65
00:31:35,590 --> 00:31:41,590
这里有点……想摸……

66
00:32:08,639 --> 00:32:14,640
蹭得好猛。是在蹭呢。

67
00:32:41,040 --> 00:32:45,100
从屁股那边都能感觉到
硬得不行。

68
00:33:11,540 --> 00:33:17,540
屁股和奶子都太棒了。
能再靠近点看吗?

69
00:35:22,120 --> 00:35:28,120
好硬。好硬。
他说从被窝里也可以

70
00:35:29,560 --> 00:35:35,560
来着。
想插进去。想插?对。

71
00:35:50,640 --> 00:35:56,640
我来吗?还是怎样?
想让你插进来。知道了。

72
00:36:37,940 --> 00:36:43,940
那我插进去了哦。插进去了。

73
00:37:07,240 --> 00:37:13,140
看得好清楚啊。插进去的地方。
插得好深啊。好爽。

74
00:38:43,720 --> 00:38:45,180
太爽了。

75
00:39:13,550 --> 00:39:18,230
爽死了……

76
00:39:47,815 --> 00:39:53,640
就是逼。全露出来了,这里。
全露出来了。看得到吗?看得到。

77
00:41:31,290 --> 00:41:37,240
发生什么了?
发生什么了?

78
00:42:25,044 --> 00:42:27,760
好猛……好猛……

79
00:43:38,934 --> 00:43:43,920
太厉害了。这辈子,太厉害了。

80
00:44:12,080 --> 00:44:14,910
已经插得超深了。

81
00:44:42,620 --> 00:44:48,420
啊,好爽……啊,抱歉……

82
00:45:12,010 --> 00:45:15,740
好爽……好爽……

83
00:46:06,919 --> 00:46:09,370
我吃饱了,爽死了款待。

84
00:46:50,620 --> 00:46:56,620
看得超清楚……好爽……

85
00:47:28,140 --> 00:47:34,140
妈妈,救救我
……妈妈……

86
00:48:20,180 --> 00:48:25,980
能看看你的脸吗?
这个,一直在啪啪贴呢。

87
00:49:08,640 --> 00:49:14,640
妈妈,救救我……妈
妈,救救我……

88
00:50:27,130 --> 00:50:33,130
好猛……好爽……爽
吗?好猛……

89
00:51:06,060 --> 00:51:07,920
叫得好大声。

90
00:52:00,970 --> 00:52:02,410
怎么样?

91
00:59:43,960 --> 00:59:49,820
可以吗?可以啊。
直接射里面吧。

92
00:59:53,020 --> 00:59:59,020
真的?想射哪都行。
我现在就想这么射。可以啊。

93
01:00:11,925 --> 01:00:17,900
看了好多……要高潮了……

94
01:00:45,420 --> 01:00:50,640
要是可以的话,下次
再来哦。

95
01:00:52,280 --> 01:00:57,940
当然。我会来的。等你哦。
这是原版

#45 DeepSeek reply at 1 hour ago

对比两份结果清楚了:原版(日语字幕)切分正常、时间轴合理(每句 4~7 秒);而你用 parakeet 跑出来的那份出现了 3~4 分钟的超长句,说明是 parakeet 日语渠道在你环境下的切分/输出异常,不是参数方向错。

一、结论原版切分正常 → 参数思路是对的,问题出在 parakeet 日语(旧版 ONNX 渠道)本身:它把长时间片段合并成超长句,这属于该渠道在当前环境下的切分缺陷,调 VAD 参数对它作用有限。

二、处置建议(二选一)换渠道(推荐):改用 Nemotron-3.5-asr-0.6b(内置)(支持日语、模型小)或 openai-whisper(内置) + large-v3,计算数据类型 int8。

用这两个的默认切分参数即可,通常不会再出 3~4 分钟超长句。

执意继续用 parakeet:把 最长语音持续(秒) 从 10 硬降到 3~4,静音分割持续 降到 300,勾选 清理已生成 重跑。

但根据你前后两份对比,该渠道很可能仍会合并长段,不保证改善。

三、重试前务必勾选 清理已生成,否则复用旧结果。

四、说明知识库未记载 parakeet 日语存在此超长句缺陷,我无法给出官方成因,仅依据你两份实测结果判断:这是该渠道的切分异常,非参数可完全修正。

建议换 Nemotron-3.5-asr-0.6b 或 whisper large-v3 重跑同一视频对比。

若换渠道后仍出现分钟级超长句,请提供版本号 + logs/ 最新日志底部约30行。

请查阅相关文档:
全部语音识别渠道说明
调节VAD精确控制语音识别
优化断句效果

#46 182.147**1 reply at 1 hour ago

谁更加精准

#47 DeepSeek reply at 1 hour ago

就"精准度"而言,需分两种含义回答,且知识库未给出这三者在日语上的实测对比数据,以下为基于渠道特性的判断:一、识别文字准确度(谁写得对)日语专用模型理论上更懂日语发音与词汇:japanese-wav2vec2-large-rs35kh(日语专用,large 级)> openai-whisper large-v3(通用大模型,日语表现较稳)> Nemotron-3.5-asr-0.6b(0.6B 轻量通用,多语言覆盖广但单语精度通常弱于前两者)二、切分/时间轴正确度(谁断句对,即你踩坑的点)这一项与模型无关,取决于渠道是否正常切分:parakeet 日语在你环境里出现 3~4 分钟超长句,切分异常,无论文字多准,整体结果都不可用。

whisper large-v3 / Nemotron-3.5-asr-0.6b 走的是标准 VAD 切分,通常正常(参考你贴的原版,时间轴合理)。

三、综合建议(对你这台 8GB 显存 + 日语 + 要求不漏句):首选:openai-whisper(内置) + large-v3 + 计算数据类型 int8——日语准确度与切分都较稳,8GB 显存可跑。

次选:Nemotron-3.5-asr-0.6b(内置)——最省显存、支持日语,精度略低于 large-v3,但切分正常、速度快。

若显存允许且追求最高日语精度:japanese-wav2vec2-large-rs35kh(但你需要先解决 8GB 爆显存问题,否则跑不动)。

四、说明知识库未记载上述模型在日语上的精准度横向实测,无法给出确定排名。

建议你截取同一小段,分别用 large-v3 与 Nemotron 跑一遍,对比 srt 文字与切分,取更优者。

请查阅相关文档:
全部语音识别渠道说明
Huggingface_ASR 内置渠道
openai-whisper 内置

#48 182.147**1 reply at 1 hour ago

japanese-wav2vec2-large-rs35kh 这解决不了爆显存啊

#49 DeepSeek reply at 1 hour ago

对,这个模型在 8GB 显存上基本解决不了爆显存,别再折腾它了。

原因:它是 wav2vec2 large 级模型,重卷积结构,显存占用随音频长度非线性暴涨,你日志里单次就申请 5.53GiB,8GB 卡无论怎么调参(切片、int8、beam)都压不到安全线。

可尝试的最后手段(不保证成功):高级选项 → 通用设置 → 强制指定重型任务运行设备,改为 CPU。

这样它完全不占显存,只吃内存和 CPU,绝对不会 OOM,代价是速度慢。

但注意:它走 CPU 时,你还设了 CPU同时任务数 12、又开着并行,可能拖慢甚至内存吃紧,建议先把 CPU同时任务数 降回 4~6。

推荐直接换掉(最省心):openai-whisper(内置) + large-v3 + 计算数据类型 int8——日语准确度和切分都较稳,8GB 显存可跑。

Nemotron-3.5-asr-0.6b(内置) + 计算数据类型 float16——模型小、支持日语,8GB 显存轻松承载,速度最快。

提醒:无论换哪个,重跑前勾选 清理已生成。

一句话:wav2vec2-large 对 8GB 就是跑不动,要么强制走 CPU(慢),要么直接换 large-v3 或 Nemotron。

请查阅相关文档:
全部语音识别渠道说明
高级选项
Windows 配置 CUDA 和 cuDNN

Thinking...
Post Your Reply
If you have more than 50 messages, you will no longer receive an automatic reply. Please ask a new question!
Open source and free maintenance is not easy. If this project is helpful to you, please consider making a small donation to help the project continue to maintain and update.

Dondate via ko-fi.com

Related resource