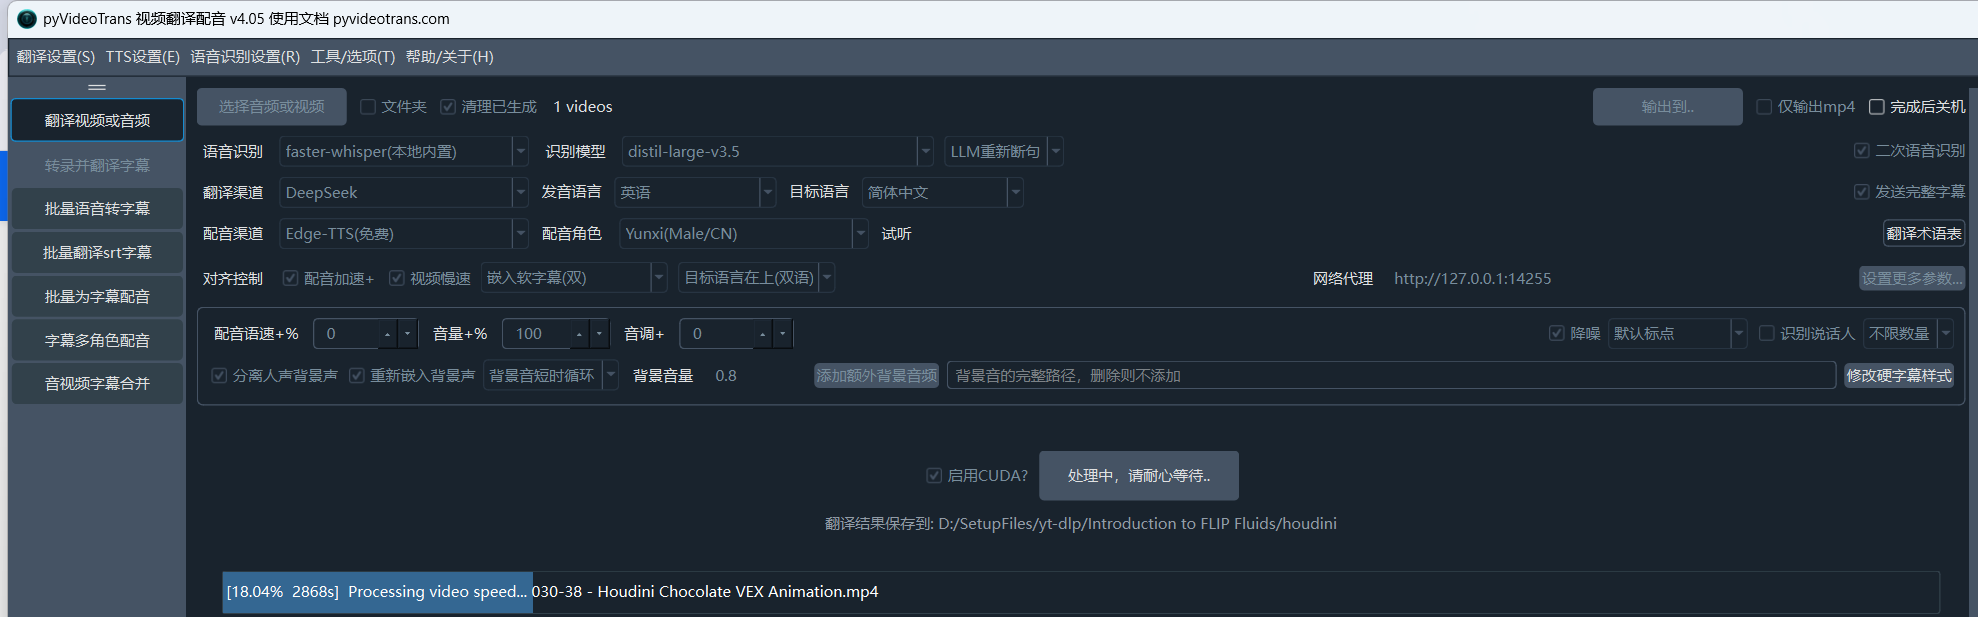
#7312 生成的en.srt字幕文件,时间总是不够,不完整,是什么情况?

52.7**2 Posted at: 1 hour ago

image
生成的en.srt字幕文件,时间总是不够,不完整,是什么情况?

3 Replies

#1 DeepSeek reply at 1 hour ago

这是因为翻译渠道返回的字幕条数与原文不一致,AI 大模型会自动合并相邻短句或增删行,导致生成的 en.srt 行数少于原文,时间轴就缺失了;软件为保护时间轴对齐会保留空白行,若字幕行数严重缺失,就表现为时长不完整。

解决办法:

  1. 高级选项 → 字幕翻译 → 取消勾选「发送完整字幕」,改为逐行翻译模式。
  2. 将「AI翻译渠道每批字幕行数」设为 1。
  3. 将「AI翻译模型温度值」调低(默认 0.1)。
  4. 更换更稳定的翻译渠道,推荐 DeepSeek 或 OpenAI 等旗舰大模型(小参数本地模型指令跟随能力弱,易合并或漏翻)。
  5. 若已开启「AI翻译附带所有字幕做参考」,在模型上下文不足时也易被截断,可关闭该选项重试。
注意:翻译后的字幕条数、时间节点必须与原始视频严格对应,空白行是软件为保护时间轴对齐刻意保留的,请勿手动删除。

请查阅相关文档:

#2 52.7**2 reply at 1 hour ago

en.srt文件不是剥离音频的软件生成的英文字幕吗?跟ai翻译没有关系吧

#3 DeepSeek reply at 1 hour ago

你的理解有误。en.srt 既可能是语音识别阶段生成的(该视频原发音语言恰为英语时),也可能是翻译阶段生成的目标语言字幕,具体取决于你的设置。

不过无论它是哪一步产生的,核心原因一致:字幕的时间轴只覆盖了部分音频,说明生成过程被截断。请按以下排查:

  1. 若 en.srt 是语音识别(ASR)直接产物(即发音语言选的就是英语):

    • 检查是否音频过长但被中途中断,导致只处理了一部分。查看 logs/ 日志是否有报错。
    • 检查 VAD 参数:若「静音分割持续毫秒」或「最短语音持续」设置过大,会把部分语音当作静音舍弃,导致识别不全。可恢复默认值重试。
    • 确认原视频音轨完整,且音量足够,避免被 VAD 过滤。
  2. 若 en.srt 是翻译步骤产物(源语言为其他语言,目标语言为英语):

    • 则是 AI 翻译渠道合并句子导致的行数缺失,按上一条回复处理(取消「发送完整字幕」、每批行数设为 1 等)。
  3. 通用检查:主界面「清理已生成」是否勾选?若未勾选,软件会复用上一次不完整的字幕文件,导致每次结果都一样残缺。建议勾选后重试。

请提供:软件左上角版本号、发音语言与目标语言的具体选择、以及 logs/ 下最新日志的报错片段,以便进一步定位。

请查阅相关文档:

Thinking...
Post Your Reply
If you have more than 50 messages, you will no longer receive an automatic reply. Please ask a new question!
Open source and free maintenance is not easy. If this project is helpful to you, please consider making a small donation to help the project continue to maintain and update.

Dondate via ko-fi.com

Related resource